Crea cualquier flujo de trabajo
Un flujo de trabajo (también llamado canalización) es un grafo de nodos. Los datos entran por un extremo, cada nodo realiza una tarea y pasa el resultado al siguiente, y el último nodo genera el resultado final: un registro, un mensaje o un informe. Esta guía le proporciona un método que funciona para cualquier flujo de trabajo, así como los patrones de control de flujo que puede combinar para construirlo. Cada patrón que se muestra a continuación se ejecutó en el motor real con datos sintéticos, y los resultados que se muestran son los que se obtuvieron.
- Referencia: Generador de flujos de trabajo para cada botón y panel, y Puertos, tipos y flujo de datos para saber cómo se mueven los datos entre los nodos.
- Primer flujo de trabajo práctico: Tu primer flujo de trabajo.
- Recetas completas: Conversión de HL7 ADT a FHIR y llamada de seguimiento de voz.
¿Es un flujo de trabajo la herramienta adecuada?
| Necesitas | Usar |
|---|---|
| Una secuencia fija de pasos con ramificaciones, la misma cada vez, que puedes probar y repetir. | A workflow (esta guía) |
| Un asistente con herramientas que decide por sí mismo qué llamar | Un agente |
| Varios pasos del modelo con roles, enrutamiento, bucles de revisión y un registro de auditoría de cada solicitud. | Un grafo de agente |
Un flujo de trabajo puede llamar a agentes como un paso (el nodo agent-executor), por lo que se pueden combinar: una infraestructura fija alrededor de un modelo que realiza el razonamiento.
El método

1. Definir el trabajo
Antes de abrir el editor, anota cinco cosas. La mayoría de los errores en el flujo de trabajo se deben a omitir alguna de ellas.
| Pregunta | Ejemplo (clasificación de resultados de laboratorio) |
|---|---|
| ¿Cómo empieza? | Alguien lo ejecuta con un resultado de laboratorio. |
| ¿Qué datos se reciben, con qué campos y tipos? | patient_id (texto), test (texto), value (un número). |
| ¿Qué decisiones toma? | ¿Es value mayor que 5,5? |
| ¿Qué se va y adónde va? | Un registro de alto valor o un registro rutinario; este ejercicio no envía ninguna notificación. |
| ¿Qué ocurre cuando falla un paso y quién lo detecta? | La ejecución falla y se muestra en Tiet · Studio → Workflows → Monitor. |
2. Elige cómo empieza
El primer nodo decide cómo se inicia el flujo de trabajo. Elija el que mejor se adapte a la tarea.
| Comenzar | Nodo | Lo que necesita | Úselo para |
|---|---|---|---|
| Run by hand or API | input | defaults (o data) y required_fields | Cualquier cosa que inicies tú mismo, con valores desde Run with inputs o la API |
| On a timer | scheduler | schedule_type (interval, once o daily), interval_seconds, execute_at, time_of_day | Tareas recurrentes. Para una expresión cron, seleccione Schedule en el menú Ejecutar (ofrece preajustes cron y una expresión personalizada, y agrega el nodo de activación), o utilice Tiet · Studio → Workflows → Monitor → Schedules (consulte Opciones de ejecución). |
| An HTTP call | api-webhook | port (9090), listen_path, auth_mode (none, header_secret, hmac_sha256), webhook_secret | Otro sistema te notifica |
| A FHIR subscription | fhir-webhook | filter_resource_type, filter_event | Reaccionar a los cambios en los recursos FHIR |
| An HL7 message | hl7-listener | listen_port (2575), filtros por tipo de mensaje, evento, aplicación de envío e instalación | Interfaces hospitalarias; consulte la receta ADT. |
| Generic event | trigger | type (manual, webhook, schedule, condition, event) | Cuando ninguna de las opciones anteriores se ajusta a lo esperado. |
El puerto output del nodo input transporta el registro completo, por lo que el siguiente nodo puede leer todos los campos.
3. Constrúyelo en el editor.
- Abre el Tiet · Studio → Workflows y elige New Workflow. Se abrirá un editor en blanco en una pestaña.
- En el panel izquierdo, seleccione Palette. Busque por nombre, ID, categoría, descripción o tipo de puerto (el cuadro dice "Buscar por nombre, tipo, puerto, estándar…") o expanda una categoría. Arrastre el nodo al lienzo.
- Seleccione un nodo. El Inspector a la derecha muestra su configuración (Node Settings) y su Ports. Complete los campos obligatorios (marcados con un asterisco rojo). La configuración está dividida en pestañas como Basic y Advanced.
La forma en que se ingresa una configuración depende de su tipo: cuadros de texto y numéricos; menús desplegables para opciones fijas; interruptores de encendido/apagado; un cuadro de texto JSON para configuraciones
jsonyany(se vuelve rojo y mantiene su texto como texto plano hasta que lo analiza); una lista con Add item para matrices comorequired_fields; y, paratransformMappings, filas con cuadros Target y Source (más Transform y Default donde el nodo los ofrece) agregados con Add field. - Dibuja una arista desde un puerto de salida (lado derecho de un nodo) hasta un puerto de entrada (lado izquierdo) del siguiente nodo.
- Coloca los valores que reutilices (una URL base, un umbral) en Resources (barra de herramientas), en la pestaña Variables, y haz referencia a ellos como
{{name}}El mismo panel tiene pestañas Connectors, Storage y Test Data.
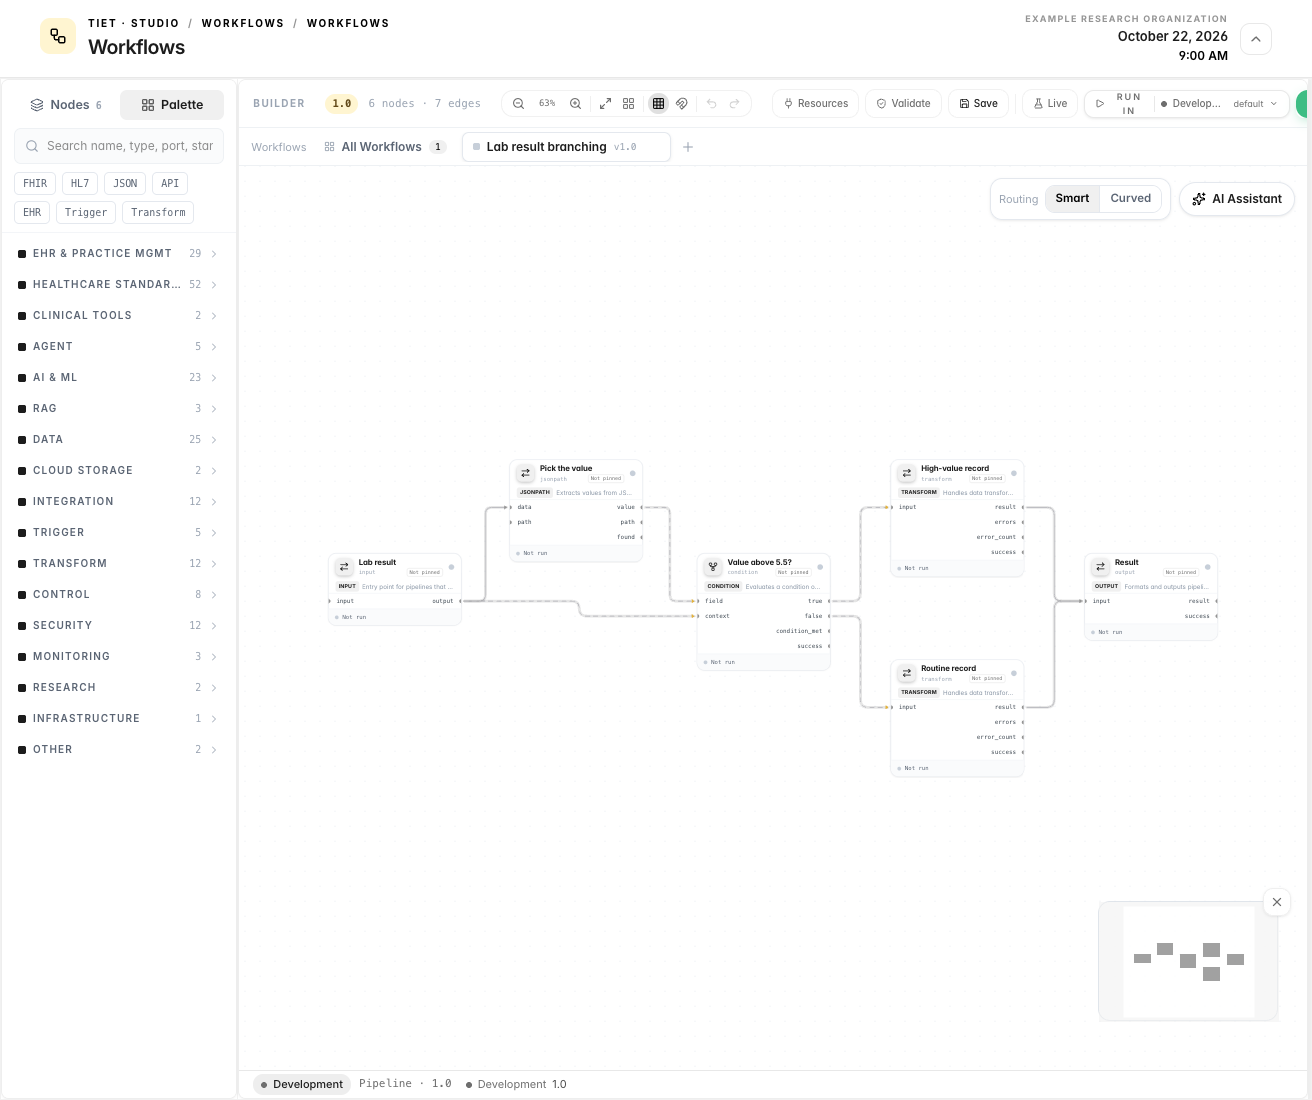
La barra de herramientas, Test izquierda a derecha: controles de zoom y diseño, Resources, Validate, Save, el interruptor Live, el selector de entorno Run in, Run (con un menú de flecha) y Deploy. Las pestañas del panel derecho son Inspector, Assistant, Diff, Docs y API, y el interruptor Routing (Smart o Curved) y AI Assistant se encuentran en la parte superior derecha del lienzo.
Seleccione un nodo para ver exactamente qué acepta y qué produce:
4. Conecte los datos correctamente
La mayoría de los problemas se resuelven con cinco reglas. La página de puertos explica cada una de ellas con ejemplos.
- Una arista conecta un puerto con otro, no un campo. Si necesitas un campo, un nodo intermedio debe extraerlo (por ejemplo, el puerto
jsonpath, cuyo puertovaluecontiene el campo extraído). En el editor, solo puedes dibujar aristas entre los puertos que declara un nodo, así que comprueba primero los puertos en el Inspector. - Un modo
transformenmaplee los datos ascendentes bajo el nombre del puerto al que está conectado, por lo que sus asignaciones comienzan coninput.(por ejemplo,input.patient_id). Sin el prefijo, los campos aparecen vacíos. - Un nodo
conditionprueba el valor en su puertofieldy transmite solo el resultado de la comparación. El puertofielddebe transportar el número en sí, no un registro que lo contenga (un registro falla convalues must be numeric for > comparison). Para llevar el registro por la rama elegida, conéctelo al puertocontexty asígnele un nombre enpass_through. - Las comparaciones numéricas necesitan números. El texto
"6.1"no es un número y falla convalues must be numeric for > comparison. - Una variable secreta no se sustituye por
{{name}}Llega al destino como texto literal. Guarde los secretos en el almacén de credenciales y utilice variables solo para valores que sean seguros de ver en el flujo de trabajo.
Si un borde utiliza un puerto que no existe en el nodo de origen, la ejecución finaliza como completed y el nodo de destino permanece como skipped. Después de cada ejecución, revise los nodos omitidos y verifique que cada uno sea el esperado.
5. Prueba, y vuelve a probar.
| Herramienta | Lo que te dice |
|---|---|
| Validate | Comprueba el flujo de trabajo antes de ejecutarlo. Solo informa de errores. No detecta nombres de puerto incorrectos ni errores en el tipo de puerto. |
| Run with inputs | Se ejecuta con los valores que introduzca en formato JSON. Los números deben ser números JSON. |
| selector Run in | Selecciona el entorno en el que se ejecuta la prueba. Un entorno que permite borradores ejecuta lo que contiene el editor; cualquier otro ejecuta solo lo que se ha desplegado en él, y el servidor rechaza el resto. |
| Live/Test alternar | El botón muestra Live (conectores reales) o Test (accesorios). En el modo Test se aplican anulaciones de accesorios y entradas para que los nodos utilicen datos predefinidos en lugar de esperar eventos reales. Dry run del menú Ejecutar se llama "Ejecutar en modo de prueba", pero guarda y se ejecuta exactamente igual que Run; sigue al interruptor, así que cambie primero al Test No asuma que ninguno de los dos evita un efecto secundario real, como una llamada telefónica. |
| Debug step-by-step | Se realizan pausas en cada nodo. Haga clic con el botón derecho en un nodo y elija Inspect Data, o selecciónelo y abra la pestaña Diff, para ver qué datos entraron y salieron. |
| EXECUTION LOG, STEP DEBUG, TRACE | El panel inferior muestra el estado de cada nodo, los datos y el árbol de expansión de la ejecución. |
Run on mesh siempre aparece en la lista pero está deshabilitado ("Establecer la ubicación de Runs-on de un nodo para habilitarla") hasta que al menos un nodo tenga un valor de Runs on (placement); consulte Run on mesh.
Prueba los extremos de tu entrada, no solo la parte central: el valor más pequeño, un campo faltante, un valor que se encuentre exactamente en un umbral.
6. Guarda una versión y publícala.
Save (Ctrl/Cmd+S) abre Save New Version, que sugiere el siguiente número de versión; cada guardado es una nueva versión. Guarda una vez antes de la primera ejecución: Run, Run with inputs, Dry run y Deploy necesitan un flujo de trabajo que se haya guardado una vez, y después guardan primero tus cambios actuales (sin una solicitud de versión). El menú Deploy muestra una entrada, Deploy vN to <environment>, para cada otro entorno, además de Export as JSON y Export as YAML; sus entradas Activate (habilitar programación, habilitar activador), push e historial de despliegue se muestran deshabilitadas. Ten en cuenta lo que Deploy hace y no hace, y lee Entornos y promoción antes de confiar en él para una versión controlada.
Después del lanzamiento, el reloj se ejecuta en Tiet · Studio → Workflows → Monitor.
Patrones de flujo de control
Rama sujeta a una condición
El nodo condition comprueba el valor que llega a su puerto field y activa su puerto true o su puerto false Solo se ejecutan los nodos conectados al puerto activo; los demás se omiten.

Descargue la definición JSON completa o la definición YAML, además de ejemplos de entrada. Las descargas completas utilizan el formato de exportación del constructor (definition.nodes y definition.connections).
El mismo patrón de ramificación en YAML abreviado (edges es el alias de conexión):
nodes:
  - id: result
    type: input
    config:
      required_fields: [patient_id, test, value]
      defaults: {patient_id: "test-patient-a", test: "potassium", value: 4.2}
  - id: pick-value
    type: jsonpath
    config:
      path: value
  - id: above-threshold
    type: condition
    config:
      field: value
      condition_type: greater_than
      compare_value: 5.5
      pass_through: {record: context}
  - id: high-value
    type: transform
    config:
      transformation_type: map
      mappings: {patient: input.record.patient_id, test: input.record.test, value: input.record.value}
  - id: routine
    type: transform
    config:
      transformation_type: map
      mappings: {patient: input.record.patient_id, test: input.record.test, value: input.record.value}
  - id: out
    type: output
edges:
  - {source_node: result,      source_port: output, target_node: pick-value,   target_port: data}
  - {source_node: pick-value,  source_port: value,  target_node: above-threshold,  target_port: field}
  - {source_node: result,      source_port: output, target_node: above-threshold,  target_port: context}
  - {source_node: above-threshold, source_port: "true",  target_node: high-value,  target_port: input}
  - {source_node: above-threshold, source_port: "false", target_node: routine, target_port: input}
  - {source_node: high-value,  source_port: result, target_node: out, target_port: input}
  - {source_node: routine, source_port: result, target_node: out, target_port: input}
Cada arista usa un puerto que declara el nodo, por lo que puedes dibujar todo el flujo de trabajo en el editor. Dos aristas salen del nodo de entrada: una hacia pick-value (para que la condición obtenga el número sin procesar en field) y otra hacia el puerto context de la condición (para que todo el registro pueda ser llevado a través de la rama elegida). Conectar el output del nodo de entrada directamente al field no funciona: el puerto lleva todo el registro y la comparación falla con values must be numeric for > comparison. La configuración field del nodo condition (value) nombra el número que se está probando; el valor que llega al puerto field es el que se compara.
Resultado de las dos carreras:
value | Puerto activo | high-value | routine | out recibe |
|---|---|---|---|---|
| 4.2 | false | omitido | corrió | {patient: "test-patient-a", test: "potassium", value: 4.2} |
| 6.1 | true | corrió | omitido | {patient: "test-patient-a", test: "potassium", value: 6.1} |
Ambas ramas alimentan un nodo out La ejecución finaliza omitiendo una rama, por lo que una unión posterior a una rama es segura. Para más de dos resultados, utilice las condiciones de nodo router (rules, default_route) o de cadena.
Filtrar y agregar una lista
Utilice filter para conservar los registros que coincidan y aggregator para contarlos o resumirlos.
nodes:
  - id: labs
    type: input
    config:
      defaults:
        data:
          - {patient_id: "pt-a", test: "potassium", value: 4.1}
          - {patient_id: "pt-b", test: "potassium", value: 6.2}
          - {patient_id: "pt-c", test: "potassium", value: 5.9}
          - {patient_id: "pt-d", test: "potassium", value: 3.8}
  - id: critical
    type: filter
    config:
      logic: AND
      conditions:
        - {field: value, operator: greater_than, value: 5.5}
  - id: count
    type: aggregator
    config: {aggregation_type: count}
edges:
  - {source_node: labs,     source_port: data,          target_node: critical, target_port: data}
  - {source_node: critical, source_port: filtered_data, target_node: count,    target_port: data}
El nodo filter devuelve filtered_data (los registros coincidentes) con filtered_count. Al ejecutarlo en los cuatro registros anteriores, conserva pt-b y pt-c, y el aggregator devuelve {"count": 2}.
El aggregator quiere un array. Conectado desde result, recibe el objeto contenedor y falla con data must be an array Conecta el campo filtered_data a su puerto data.
Los operadores de filtro incluyen equals, not_equals, greater_than, less_than, contains, starts_with, regex, in, not_in, exists, is_empty y is_null (y formas abreviadas como gt, ==, >=). aggregation_type puede ser count, sum, average, min, max, group o distinct.
Combinar dos fuentes
Dos nodos sin dependencia entre sí se ejecutan en el mismo lote, en paralelo. Únalos con un nodo merge:
  - id: combine
    type: merge
    config: {merge_type: object, sources: [demographics, vitals]}
edges:
  - {source_node: demographics, source_port: output, target_node: combine, target_port: demographics}
  - {source_node: vitals,       source_port: output, target_node: combine, target_port: vitals}
Con demographics = {patient_id: "pt-a", name: "Test Patient A"} y vitals = {heart_rate: 72, spo2: 97}, merge devolvió merged: {heart_rate: 72, name: "Test Patient A", patient_id: "pt-a", spo2: 97}, field_count: 4 y source_count: 2. merge_type es object, array u concat.
Repasar una lista
El nodo loop (loop_type: for_each, while o until) emite una lista con un índice para cada elemento:
{"count": 2, "results": [{"index": 0, "item": {"patient_id": "pt-a"}}, {"index": 1, "item": {"patient_id": "pt-b"}}]}
El nodo genera la lista indexada una sola vez, y los nodos posteriores se ejecutan una sola vez. No repite la rama descendente para cada elemento. Un grafo de flujo de trabajo nunca puede contener un ciclo (el motor lo rechaza en tiempo de compilación). Para el procesamiento por registro, utilice batch (batch_size, parallelism, continue_on_error) o realice el trabajo dentro de un nodo que acepte una lista.
Gestionar el fracaso a propósito
Por defecto, un nodo que falla hace que la ejecución falle (fail_fast). Puedes cambiar eso para un nodo con error_handling, y puedes reintentar los errores transitorios con retry.

  - id: write
    type: fhir-crud
    config: {operation: transaction, fhir_url: "{{FHIR_URL}}"}
    error_handling: {strategy: log_and_continue}   # fail_fast (default), log_and_continue, fallback
    retry: {max_retries: 3, initial_delay_ms: 500, backoff_factor: 2, jitter: true}
  - id: report
    type: output
    accept_outcomes: [succeeded, degraded]          # needed to run after a degraded node
En la prueba, write falló en tiempo de ejecución porque se le pasó algo que no era un Bundle. Lo que hizo el motor:
| Configuración | Resultado |
|---|---|
fail_fast | write falló con transaction input must be a Bundle, got resourceType=<nil>, y la carrera terminó failed. |
log_and_continue, siguiente nodo sin accept_outcomes | write se completó con el resultado degraded y salidas vacías, y el siguiente nodo falló: node after requires a successful outcome from bad (received degraded). |
log_and_continue, siguiente nodo con accept_outcomes: [succeeded, degraded] | El siguiente nodo se ejecutó y la ejecución finalizó partial. |
Utilice log_and_continue únicamente cuando el resto del flujo de trabajo pueda continuar sin la salida de ese paso, y deje que el nodo posterior gestione los datos faltantes. Una ejecución que finaliza con partial no es exitosa: supervise este proceso.
Otros nodos de control: validator (rules, strict_mode; con strict_mode fuera un registro fallido pasa con valid=false), error-handler (strategy: catch, fallback, transform, retry_info) y delay.
Antes de confiar en un flujo de trabajo
- Cada campo obligatorio tiene un valor, y los identificadores exactos de los nodos provienen de la paleta.
- Lo ejecutaste con una entrada normal, una entrada de caso límite y una entrada con un campo faltante.
- No se mostrará ningún nodo omitido a menos que así lo esperaras.
- Los números son números, y ningún secreto reside en una variable.
- El manejo de errores es intencional: sabes qué significa una ejecución
degradedopartialpara el siguiente paso. - Todo aquello que escribe en un sistema clínico escribe propuestas o borradores, no registros finales, a menos que una persona los revise. Véase Agentes y gobernanza.
- Solo has realizado pruebas con datos sintéticos.
Cuando no funciona
| Síntoma | Causa probable | Arreglar |
|---|---|---|
| Un nodo muestra omitido. | Su borde de entrada está en un puerto condition que no estaba activo, o el nombre de un puerto en un borde es incorrecto. | Verifique el nombre del puerto de origen en el borde (true o false para una condición). |
Un campo mapeado es null. | El mapeo carece del prefijo del nombre del puerto. | Usar input.<field>. |
values must be numeric for > comparison | Un valor de texto alcanzó una comparación numérica. | Proporcione un número. |
data must be an array | Un nodo de lista recibió su objeto contenedor. | Conecte el campo de lista (por ejemplo, filtered_data). |
compilation failed: node release xyz@ is unavailable | El ID del nodo no se encuentra en el catálogo. | Copia el ID de la paleta. |
compilation failed: ... circular dependency detected | El gráfico tiene un ciclo. | Elimina el borde que se curva hacia atrás. |
node ... validation failed: <field> is required | Un ajuste obligatorio está vacío. | Rellénalo en la oficina del inspector. |
requires a successful outcome from <node> (received degraded) | El nodo anterior terminó degraded bajo log_and_continue. | Añade accept_outcomes a este nodo, o deja de usar log_and_continue en el anterior. |
La carrera es partial. | Al menos un nodo terminó en degraded. | Abre la ejecución en Monitor y comprueba cuál. |
En Puertos, tipos y flujo de datos encontrará más errores, incluidos los relacionados con el flujo de datos.
¿Adónde vamos?
- Tu primer flujo de trabajo: crea el flujo de trabajo de triaje paso a paso en el editor.
- Receta: Conversión de HL7 ADT a FHIR: un flujo de trabajo para la recepción de mensajes hospitalarios.
- Construye un gráfico de agente y crea un agente: cuando un paso necesita un modelo que razone.
- Creador de flujos de trabajo: la referencia completa.
¿Algo no está claro? Envíe sus comentarios sobre la documentación por correo electrónico..